case study · Datos & IA
Arce
Inteligencia de mercado sobre las compras del Estado uruguayo.
Cada respuesta de la IA se guarda junto con las cifras exactas que vio. Cualquier conclusión se puede rastrear hasta el número que la respalda.
Arce junta el histórico de compras estatales de Uruguay (qué se adjudicó, a quién, a qué precio y qué organismo lo compró) y lo convierte en estadísticas comparables: qué productos conviene vender, a qué precio se gana y contra quién se compite. Un modelo de IA lee esas cifras y escribe el análisis para la dirección, sin calcular nada por su cuenta.
01 · problema de negocio
Arce nació para otra cosa: leer el portal de compras estatales (ARCE) cada 15 minutos y decirle a la empresa qué llamados abiertos de aluminio le servían. Esa parte sigue funcionando.
Después la dirección hizo una pregunta más grande: no qué licitación sirve hoy, sino qué conviene venderle al Estado, a qué precio y contra quién. Eso no sale de los llamados abiertos de un rubro. Hace falta todo el histórico de adjudicaciones, de cualquier producto, y compararlo de forma honesta.
02 · restricciones
Lo que había que tener en cuenta.
Todavía sin datos
La descarga masiva del histórico va a ser un servicio aparte. Este sistema tenía que estar listo para recibirla y sacar las estadísticas solo, sin trabajo manual, apenas lleguen los lotes.
Datos públicos, pero desprolijos
Pesos, dólares y unidades indexadas; kilos, litros y resmas; precios con y sin impuestos; llamados anulados; proveedores que a veces llegan sin RUT. Comparar eso sin normalizar es comparar ruido.
Millones de filas
Con el histórico completo, los rankings no se pueden calcular en cada consulta.
Números que se puedan defender
Las conclusiones van a la dirección para decidir qué vender. Una cifra sin origen, o una IA que inventa, no sirve.
la decisión clave
Los números salen de SQL. La IA los interpreta, no los calcula.
Lo tentador era darle los datos a un modelo y pedirle conclusiones. Pero un modelo que calcula se puede equivocar sin que nadie lo note, y no hay forma de reproducir cómo llegó a un número.
Por eso las estadísticas se calculan en PostgreSQL y el modelo solo recibe un paquete con las cifras ya hechas. Responde con un esquema fijo y citando números, los productos que menciona se verifican contra el paquete, y cada respuesta queda guardada junto con lo que vio.
03 · decisiones técnicas y por qué
Por qué está construido así.
Contrato tolerante, estructura estricta
La API de ingesta acepta lo que el portal muestra (números con coma, fechas dd/mm/aaaa, la moneda como aparece) y lo normaliza. Pero un ítem sin número o una adjudicación sin proveedor se rechaza con el detalle del error, por llamado, sin tirar el lote entero.
Cada llamado viaja entero
Un llamado llega con sus ítems, ofertas y adjudicaciones y reemplaza su versión anterior en una transacción. El crudo se guarda con un hash: lo repetido no se reprocesa y, si cambian las reglas, todo se recalcula desde los crudos sin volver a scrapear.
Comparar solo lo comparable
Todo en pesos uruguayos sin impuestos, con la cotización del día de cada adjudicación. El precio se compara solo dentro de la misma unidad, sin llamados anulados, y con medianas y percentiles en vez de promedios.
Estadísticas precalculadas
Ocho vistas materializadas en PostgreSQL, con una fila por adjudicación como base. Se recalculan solas un minuto después del último lote y todas las noches, sin bloquear el tablero.
Un índice de oportunidad a la vista
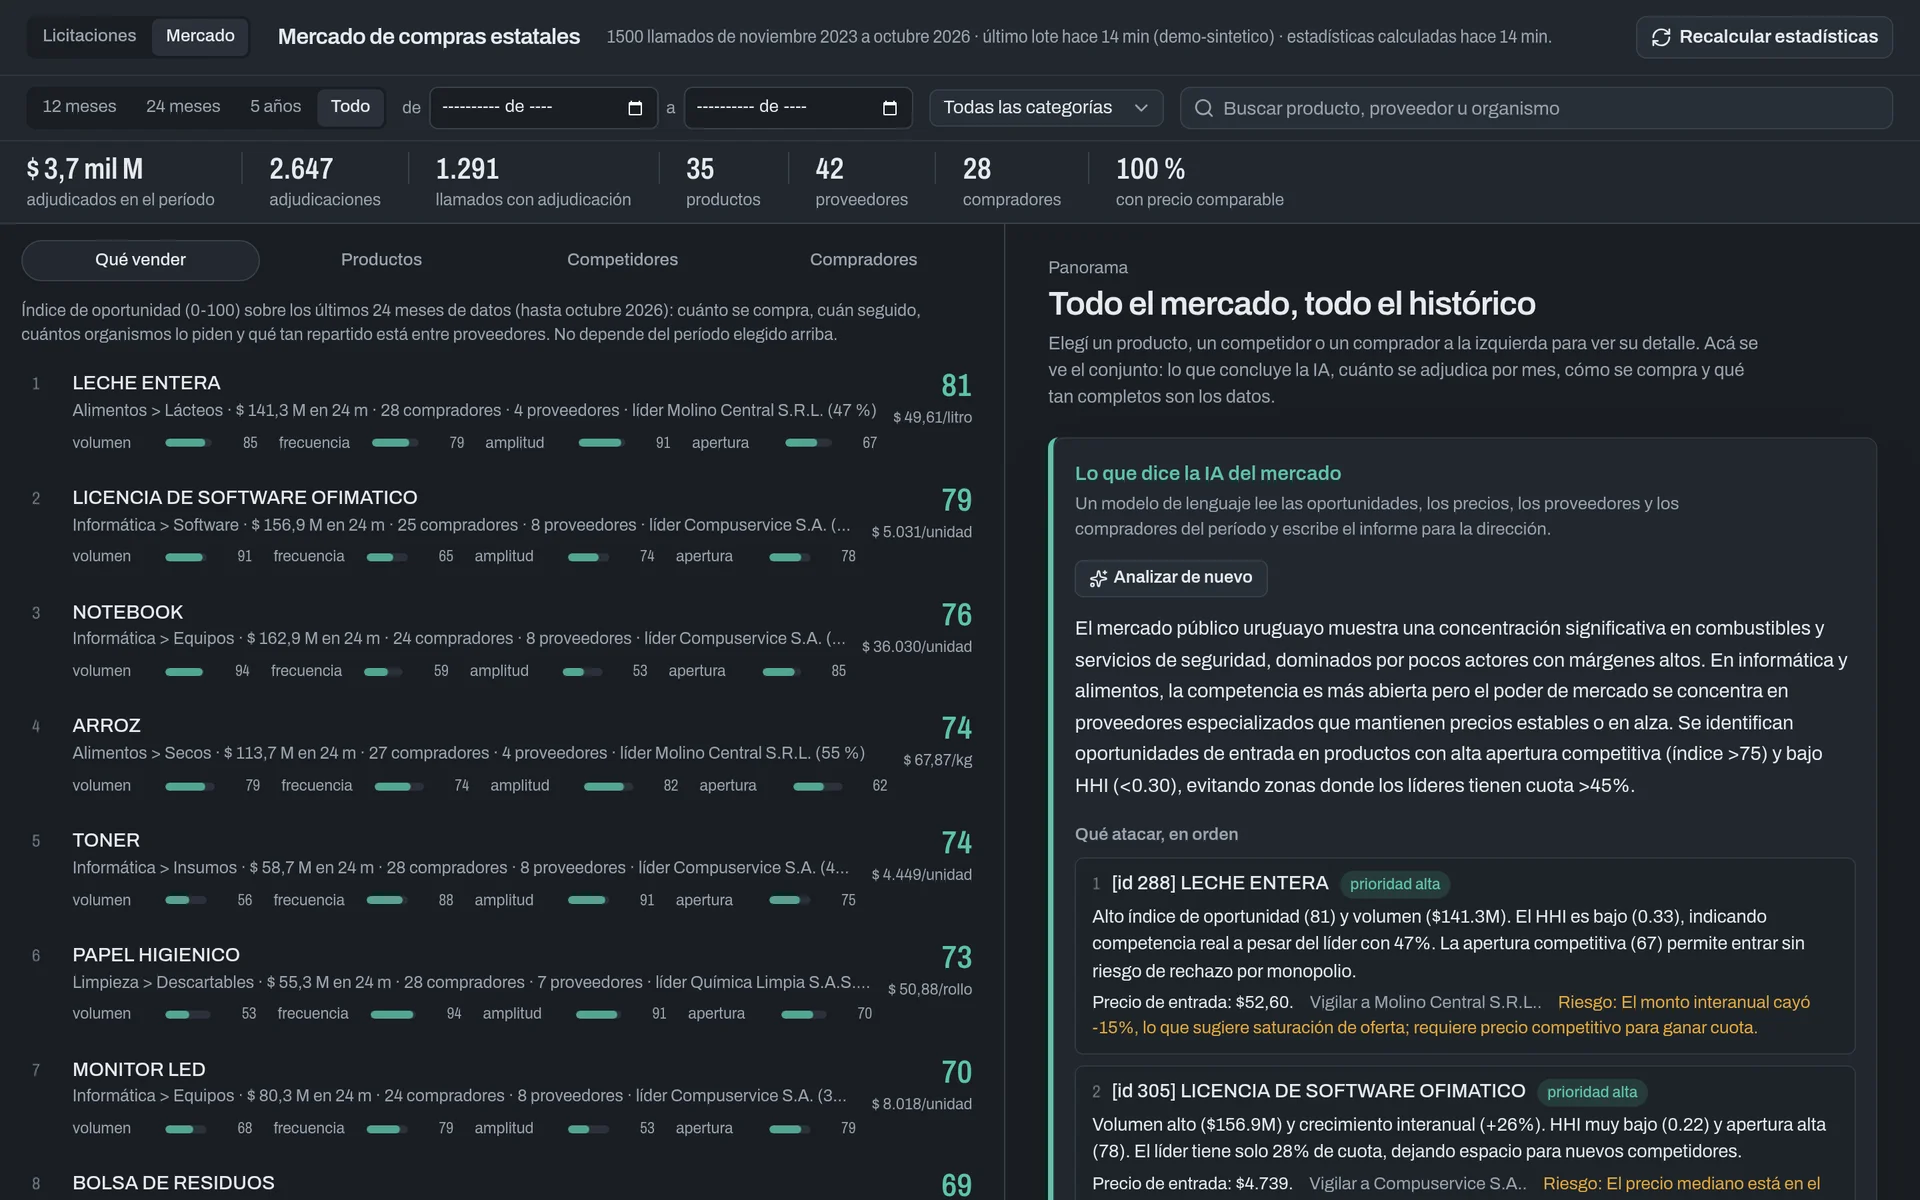
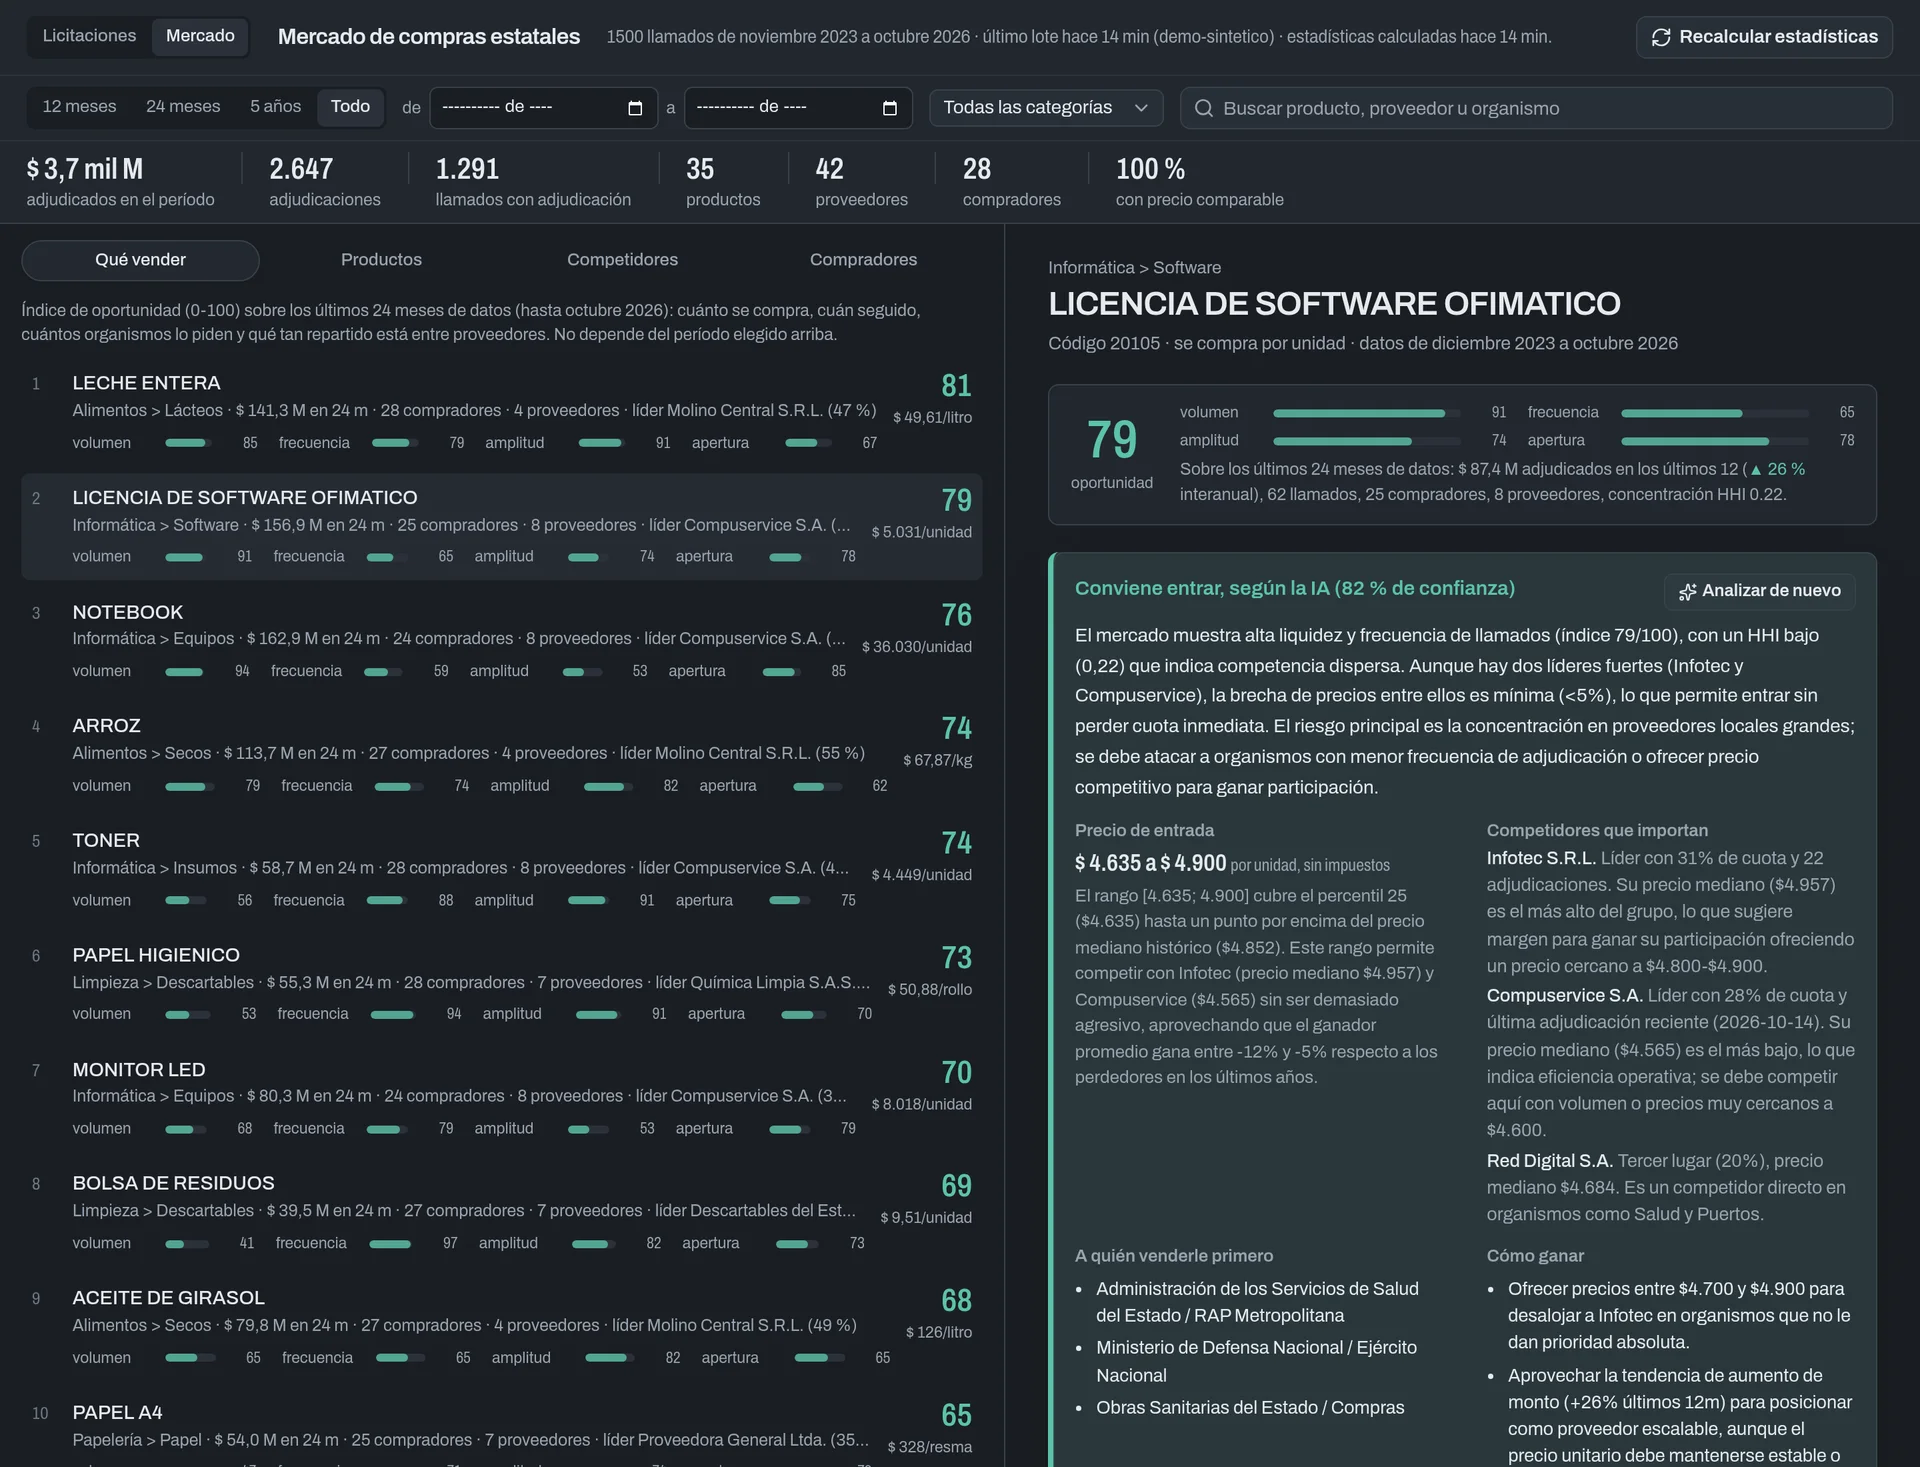
Un puntaje de 0 a 100 por producto que combina volumen, frecuencia, cuántos organismos lo compran y qué tan repartido está entre proveedores. Los pesos están en una línea de SQL y el tablero muestra los cuatro componentes.
El mismo modelo, local o en la nube
El analista usa el proveedor del resto del sistema: Ollama en CPU (uno a tres minutos por informe) o la API de Anthropic (segundos). El paquete de datos se recorta al contexto de cada modelo.
04 · qué se descartó
Lo que descarté en el camino.
Que la IA calcule
Más rápido de armar, pero los números no se pueden reproducir ni auditar. El modelo lee cifras; no las produce.
Promedios
Un solo precio mal cargado en el portal arrastra la estadística entera. Medianas y percentiles lo absorben.
Un modelo de scoring entrenado
Sin datos reales todavía, una fórmula visible que se ajusta en una línea es más honesta que una caja negra. Primero hay que ver el mercado real.
Un endpoint por entidad
Ítems, ofertas y adjudicaciones por separado le complicaban la vida al scraper y hacían difícil que reenviar un lote no duplicara nada.
qué se construyó
Del dato crudo a una recomendación con cifras.
- 01
API de ingesta
Recibe lotes de llamados históricos con token, los valida contra un contrato publicado como JSON Schema y guarda el crudo.
- 02
Normalización
Proveedores por RUT, artículos por código del catálogo de ARCE, organismos, monedas y unidades llevados a un mismo canon.
- 03
Qué vender
Ranking de productos por índice de oportunidad, con el desglose de cada puntaje.
- 04
A qué precio
Distribución del precio ganador por producto y unidad, tendencia mensual y, donde el portal publica el cuadro comparativo, cuánto más barata fue la oferta que ganó.
- 05
Quién gana y quién compra
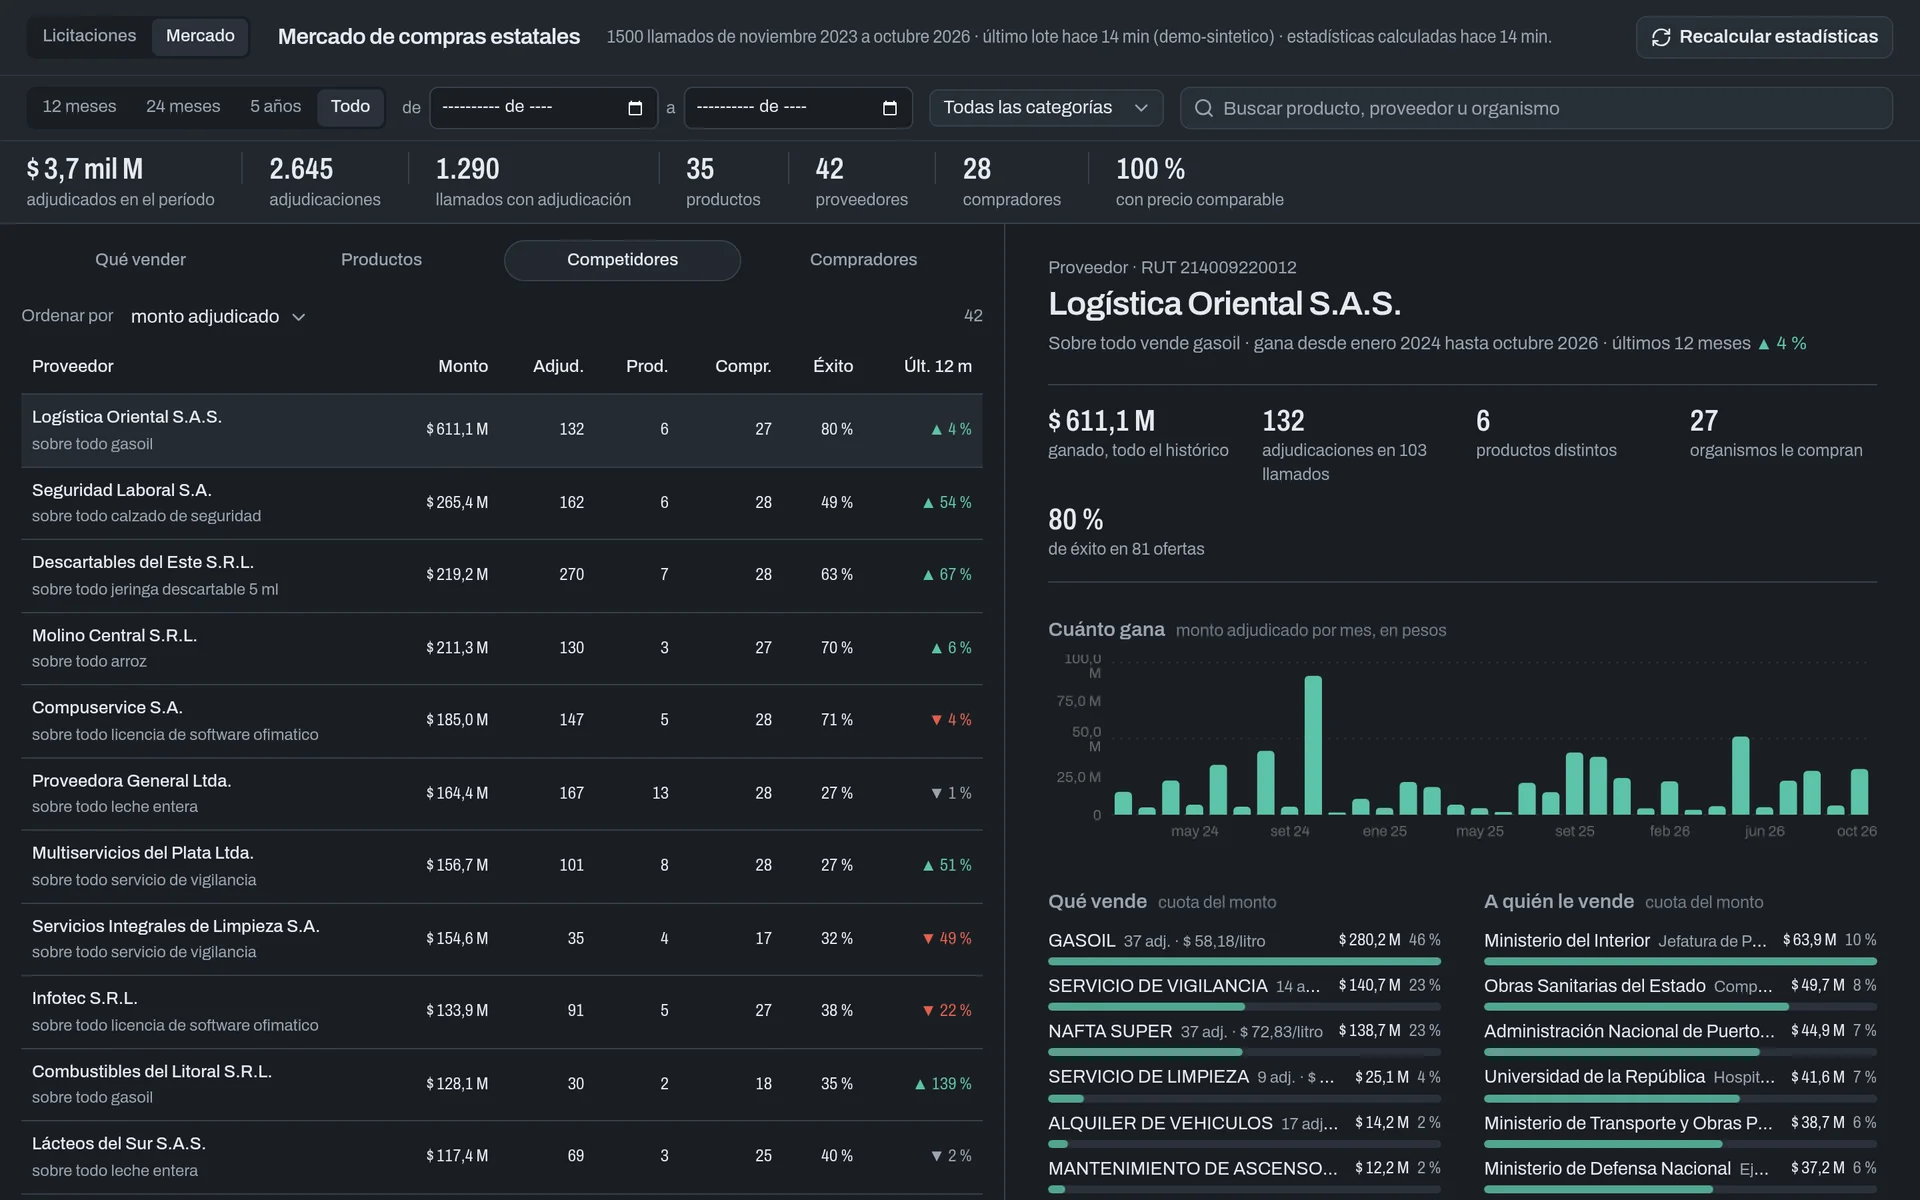
Proveedores con su cuota, tasa de éxito y contra quién compiten; organismos con lo que más compran.
- 06
El analista de IA
Un informe del mercado para la dirección, un veredicto por producto (entrar, explorar o evitar, con precio de entrada) y respuestas a preguntas libres, siempre citando los datos.
La primera etapa sigue en el mismo servicio: el monitor del rubro lee el portal cada 15 minutos, analiza los pliegos con IA y deja los llamados en una bandeja de revisión. Lo que falta es el scraper del histórico; mientras tanto, el tablero se probó con tres años de compras sintéticas que entran por la misma API.
arquitectura
Cómo fluyen los datos, del lote al tablero.
Scraper del histórico (pendiente)
Un servicio aparte que recorre el portal y manda lotes de llamados por API.
Ingesta
Token, contrato en Zod, crudo con hash y una transacción por llamado.
PostgreSQL normalizado
Organismos, proveedores, artículos, llamados, ítems, ofertas, adjudicaciones y cotizaciones.
Vistas materializadas
Una fila por adjudicación en pesos sin impuestos y, sobre ella, precios, rankings y competencia.
Analista (Ollama o Anthropic)
Lee un paquete de cifras y responde con JSON validado, guardado junto al paquete.
API y tablero
Express y React: qué vender, productos, competidores y compradores.
Vive en el mismo servicio en Docker que el monitor del rubro, con módulo y esquema de base propios: el pipeline original no se tocó.
05 · resultado
Qué quedó funcionando.
apenas el scraper mande lotes, las estadísticas se recalculan solas, sin pasos manuales.
los productos que menciona la IA se verifican contra los datos que recibió; los que no existen se descartan.
el tablero dice qué parte de los datos tiene precio comparable y qué quedó afuera, y por qué.
con tres años de compras sintéticas por la misma API y un test de integración contra una base real.
capturas
El tablero, con datos de demostración.
aprendizajes
- Cuando cambia la pregunta, cambia el dato que importa: pasar de "¿me sirve este llamado?" a "¿qué conviene vender?" movió el centro del sistema del pliego a la adjudicación.
- Lo difícil de comparar precios no es la estadística sino la normalización: moneda, unidad e impuestos deciden si un número significa algo.
- Separar quién calcula de quién interpreta deja que la IA sume sin convertirse en una fuente de cifras sin respaldo.
- Construir el receptor antes que el scraper, y probarlo con datos sintéticos por la misma puerta, dejó el contrato validado antes del primer dato real.
¿Querés hablar de este proyecto?
El código es público. Si querés discutir el diseño o hablar de una posición, escribime.